 LiveCodeBench
定位:整体评测加防数据污染
官网全称把两个主张都写进去了:对代码大模型做「整体的」且「防数据污染」的评测。发起者是三所高校的研究者团队。题目不是自己出的,而是持续从编程竞赛平台的周期性比赛里收录新题,官方列出的来源是三个知名竞赛站。这种方式有个副作用上的好处:题目自带发布时间,而发布时间正是防污染的抓手。它要解决的是两个老问题——基准题被悄悄训练进模型,以及只测代码生成这一种能力就下结论。
深度介绍
官网全称把两个主张都写进去了:对代码大模型做「整体的」且「防数据污染」的评测。发起者是三所高校的研究者团队。题目不是自己出的,而是持续从编程竞赛平台的周期性比赛里收录新题,官方列出的来源是三个知名竞赛站。这种方式有个副作用上的好处:题目自带发布时间,而发布时间正是防污染的抓手。它要解决的是两个老问题——基准题被悄悄训练进模型,以及只测代码生成这一种能力就下结论。
官方给每道题标注发布时间,因此可以只在某个模型训练截止日之后发布的题目上评测它,用没见过的题衡量泛化。首页给出了一组按月对比的图:某个开源模型家族在 2023 年 9 月之后发布的题目上出现明显断崖式下滑,提示更早的题目可能已被污染进训练集;相比之下若干闭源接口模型各月表现相对稳定。这组对比说明了为什么「按发布时间切题」比「固定题库跑分」更难作弊。
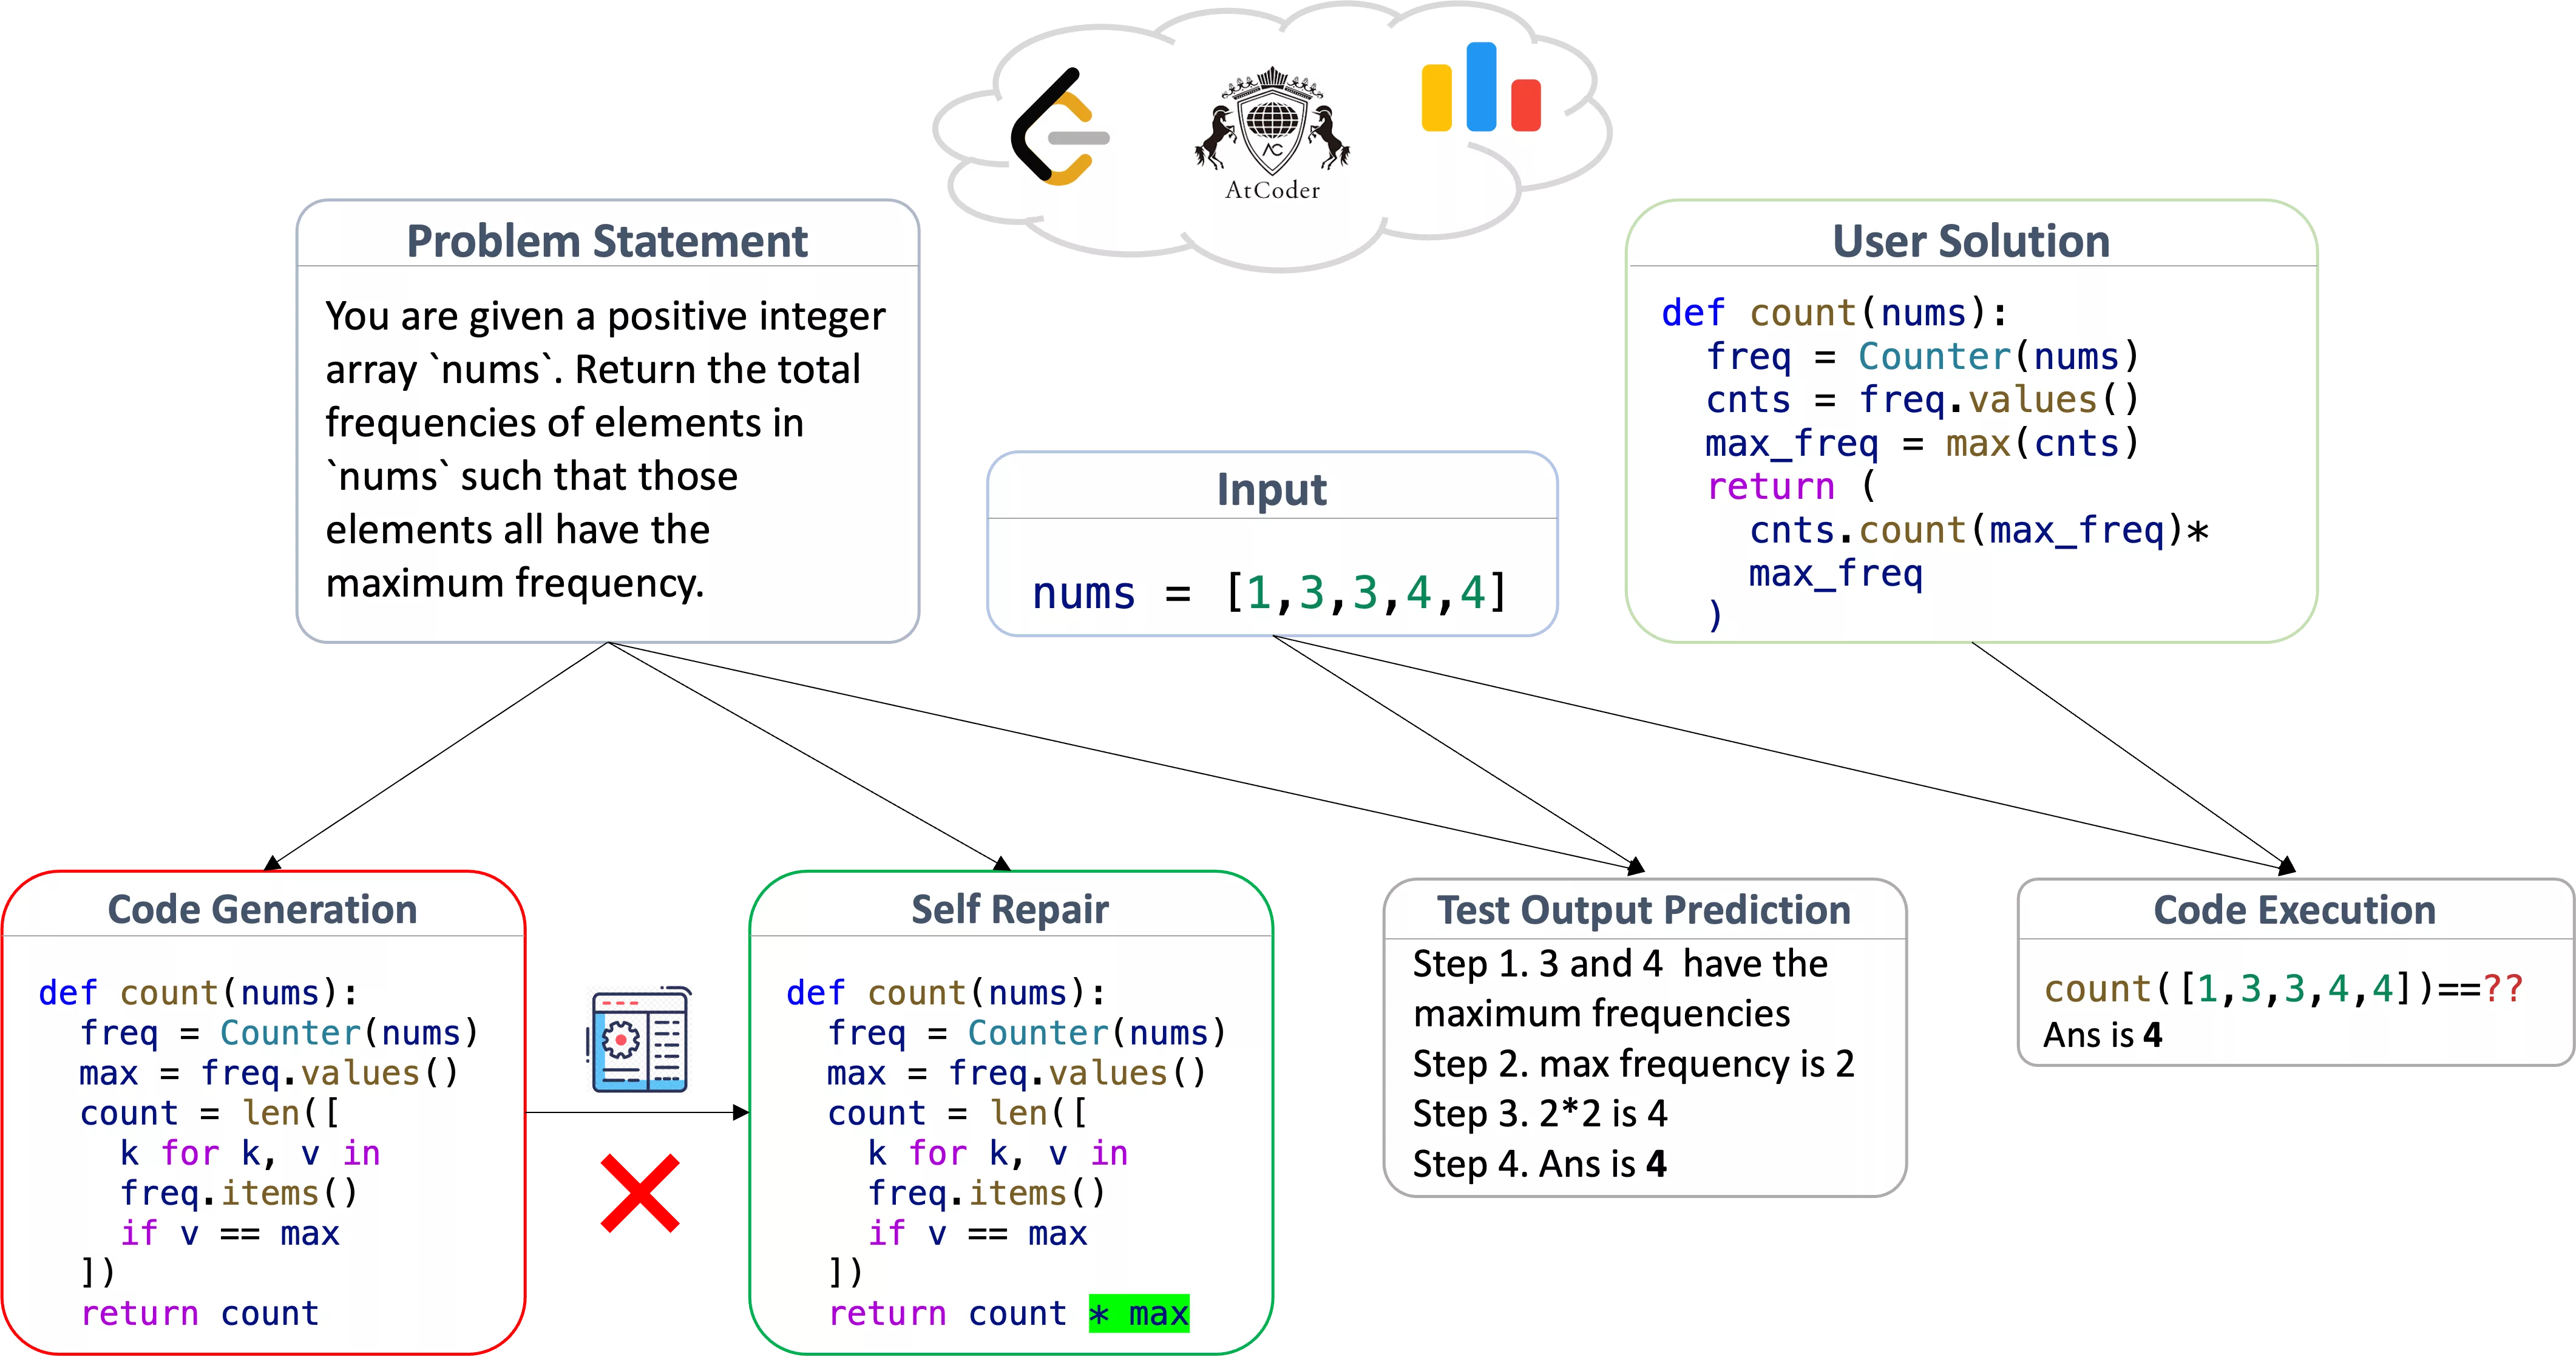
除了代码生成,官方还测三类常被忽略的能力:自我修复(拿到报错再改)、代码执行、以及测试输出预测(不运行就猜测试结果)。官方发现同一个模型在不同场景里的相对排名会变——有的模型在生成上领先,换到测试输出预测就可能被超过。这正是它自称「整体评测」的依据:只看单一场景的榜单会给出片面结论,不同场景考察的其实是不同的短板。
其一,官方对比了开放权重与闭源接口模型:总体上闭源接口更强,而开放权重要跨过某条线,主要靠的是 30B 以上大模型的微调版本。其二,他们指出在老牌代码基准上表现好的模型可能只是过拟合了那个基准——把模型分成两簇,一簇在老基准与自家简单档上表现相当,另一簇老基准很高但简单档明显落后,且后者多为开源模型的微调版本。官方由此认为开源社区的微调数据多样性不足,需要面向更广的代码任务优化。
论文口径的题量是三百多道高质量题,覆盖 2023 年 5 月到 2024 年 2 月发布的竞赛题。数据在 Hugging Face 上按场景拆开发布:代码生成、测试生成、执行、执行第二版,以及一个轻量版代码生成集。轻量版是分发最广的一个,核验时下载量十一万以上、最近一次更新在 2025 年 6 月;另有专门的提交数据集。榜单本身也做成了在线页面,2024 年 4 月上线。
代码榜单页按 Pass@1 汇总,并把题目按易、中、难三档拆开看,页面数据由脚本动态加载。想让自己的模型上榜也不用联系作者:官方公开了提交仓库,做法是把你的模型输出目录拷进提交目录、发一个合并请求,由官方审核后加进榜单。这条流程把「评测谁」变成了公开可参与的过程,也顺带让提交物可复查——别人想核对分数时有原始输出可看。
官网导航里新增了 GSO 榜单,方向从「写对代码」扩到「把代码跑快」:它是面向编程智能体的软件优化基准,用 10 个代码库里的 102 个优化任务,衡量模型能否做出接近专家水平的运行效率提升——即在通过正确性测试的前提下,相对专家优化达到至少 95% 的加速。榜单按单次尝试与多次里取最好两种口径给分,并列出所用的脚手架;官方另有专门站点放完整细节、论文与数据集下载。对做性能智能体的团队,这条线比传统基准更接近真实需求。
实际使用上有三个入口:官网看方法与发现,榜单页看当前分数,Hugging Face 数据集下载后跑自己的评测。代码仓库是 MIT 许可,核验时约 950 星标,数据集公开,引用按官方给的 BibTeX 走。要留意两点:榜单分数依赖提交结果与审核流程,页面又是动态加载,具体分数以访问当时为准;题源是竞赛题、会随时间加新题,因此不同期的模型总分不宜直接对比,要用「发布时间切片」把可比性重新对齐。
产品特点
每道题都带发布时间,评测时可以只用训练截止日之后发布的题目。这把「基准被背进训练集」从一个信任问题变成一个可检查的问题:模型在新题上的表现才说明泛化,而官方的按月对比已经展示过污染留下的断崖。
代码生成之外还测自我修复、代码执行与测试输出预测,且官方发现不同场景下模型排名会变。单一场景的高分可能只是短板没被暴露,四类一起看才能判断一个模型在真实开发里到底行不行。
官方公开了提交仓库:把模型输出拷进提交目录、发一个 PR,审核通过就进榜。评测从「作者说了算」变成公开流程,分数背后始终有可复查的原始输出。
新榜用 10 个代码库的 102 个优化任务,要求在通过正确性测试的同时达到专家优化至少 95% 的加速,并按单次与多次两种口径给分。只测对错的基准测不出优化能力,这条线补的正是这块。
最近动态
核验时官网导航已同时挂出代码能力榜单与标注为新的 GSO 榜单,提交仍走公开仓库的合并请求流程;Hugging Face 上的数据集与榜单空间均可正常访问。代码榜单页按 Pass@1 汇总并分易中难三档,数据动态加载;GSO 榜单页按优化口径给分并列出脚手架,分数从官方站点拉取。
分发最广的轻量版代码生成数据集在 2025 年 6 月 5 日最近一次更新,核验时下载量十一万以上;执行任务的第二版数据集更新于 2024 年 11 月底。各场景数据集分头维护的做法说明它没有停在论文版的题集上,而是随评测需求持续调整数据。
论文以预印本形式发布,公开了方法、四类场景设计与当时的实证发现;同月上线代码生成与测试生成两个数据集,四月上线在线榜单空间。此后仓库以 MIT 许可维护,数据与榜单在 Hugging Face 持续分发,构成了这条评测线今天的基础形态。
LiveCodeBench 是一个代码大模型评测基准,名字里点明了两个主张:整体评测与防数据污染。它由三所高校的研究者发起,题目不是自己出的,而是持续从编程竞赛平台的周期性比赛收录新题,官方列出的题源是三个知名竞赛站;论文口径的题量是三百多道高质量题,覆盖 2023 年 5 月到 2024 年 2 月发布的题目。 防污染是它的核心机制:每道题都标注发布时间,因此可以只在某个模型训练截止日之后发布的题目上评测它,用没见过的题衡量泛化。官网给出了一组按月对比的图:某个开源模型家族在 2023 年 9 月之后发布的题目上出现明显断崖式下滑,提示更早的题目可能已被污染进训练集,而若干闭源接口模型各月表现相对稳定。整体性体现在场景上:除代码生成外还测自我修复、代码执行与测试输出预测,且官方发现同一模型在不同场景里的相对排名会变。 两组实证发现值得记。一是开放权重与闭源接口的对比:总体上闭源接口更强,开放权重要跨过某条线主要靠 30B 以上大模型的微调版本。二是对老牌代码基准的过拟合怀疑:官方把模型分成两簇,一簇在老基准与自家简单档上表现相当,另一簇老基准很高但简单档明显落后、且多为开源模型的微调版本,由此认为开源社区的微调数据多样性不足。 数据与榜单的分发很直接:各场景数据集分头发布在 Hugging Face 上,代码生成、测试生成、执行、执行第二版与轻量版齐全;轻量版下载量十一万以上、2025 年 6 月最近更新,榜单空间 2024 年 4 月上线。代码榜单按 Pass@1 汇总并分易中难三档、数据动态加载;提交不用联系作者,官方公开提交仓库,把模型输出拷进提交目录发合并请求、审核后即上榜。代码仓库为 MIT 许可,核验时约 950 星标。 新扩展的 GSO 榜单把评测从「写对代码」推到「把代码跑快」:面向编程智能体的软件优化基准,用 10 个代码库的 102 个优化任务,要求在通过正确性测试的同时相对专家优化达到至少 95% 的加速,按单次尝试与多次取最好两种口径给分并列出脚手架,官方另有专门站点放论文与数据下载。使用时留意两点:分数依赖提交与审核、页面动态加载,以访问当时为准;题源随时间加新题,不同期模型的总分要用发布时间切片对齐再比。
核验信息
本页事实来自官方渠道:官网首页与论文(项目定位与发起机构、题源为三个竞赛平台的周期性比赛、题量与时间范围、四类评测场景、按发布时间标注与训练截止日后出题评测的防污染机制、按月对比的污染观察、开放与闭源的对比结论、老基准过拟合的两簇发现与开源微调数据多样性不足的结论、BibTeX)、代码能力榜单页(Pass@1 与易中难三档)、GSO 榜单页及其官方站点(10 个代码库 102 个优化任务、单次与多次两种口径与至少 95% 加速线、脚手架列、论文与数据下载入口)、Hugging Face 各数据集与榜单空间(创建与更新时间与下载量、榜单空间上线时间),以及代码仓库(MIT 许可、星标数、合并请求提交流程)。页内未列出发现部分作为示例出现的第三方模型名称。状态核验于 2026 年 9 月 22 日。
LiveCodeBench介绍页面对您是否有帮助?